# 数据导入
# 目标读者
本文档的目标读者可能包括:
- 本系统的开发及实施人员
- 准备导入数据的用户数据管理员
# 功能说明
本系统遵循一切皆数据的原则:领域模型、表单、菜单、权限、动态逻辑等元数据和业务数据一样,都可以通过 CSV 文件导入,导入时支持新建、更新、删除。
提示
本系统的 CSV 解析格式基于 RFC 4180 (opens new window) 标准,另外把反斜杠(\)作为转义符,见特殊字符的转义。
种子数据(Seed Data)一般是指在应用程序初始化或部署时插入数据库的一组初始数据。牧言低代码平台的设计原则是包括定制代码在内的一切皆数据,整个业务系统完全可以由种子数据构建。
平台当前没有数据导出功能,界面和接口都不提供把数据导出为 CSV 的能力。
如果你习惯通过例子学习,可以直接查看一个完整的例子。各类平台对象的 CSV 列说明见 CSV 导入模板。
# 导入方式
当前支持三种导入方式:
| 方式 | 适用场景 |
|---|---|
| 系统启动时自动导入 | 开发环境、插件开发,随代码一起维护的种子数据 |
| 插件数据导入 | 以插件包的形式发布、安装一组数据 |
| 在列表页导入数据 | 在界面上向某个模型批量导入数据 |
# 系统启动时自动导入
后端每次启动时,按以下顺序导入:
- 平台自带的种子数据(镜像内的
/app/platform_data)。只在平台版本(AppVersion)变化时重新导入;开发环境(GRAILS_ENV=development)、设置了环境变量FORCE_RELOAD_SEED_DATA=true、或系统配置debugDynamicLogic.forceRefreshDomainDefinition为true时每次都导入。 - 应用的种子数据目录(见种子数据目录):先导入
plugins子目录中的插件包,再导入csv子目录中的 CSV 文件。
每个 CSV 文件导入前都会做文件更新判断,内容没有变化的文件会被跳过,所以修改 CSV 后重启后端服务即可让修改生效。
# 插件数据导入
插件包是一个 zip 文件,根目录下包含:
| 路径 | 说明 |
|---|---|
PLUGIN_INFO | 插件信息,JSON 格式,包含 name、version、description、dependsOnPlugins(依赖的插件名及最低版本) |
csv/ | 插件的种子数据 CSV |
libs/ | 插件的 jar 包 |
sql/ | 可选,导入前后执行的 SQL,见导入前后执行 SQL |
插件可以通过两种方式导入:
- 放在种子数据目录的
plugins子目录下,系统启动时自动导入。 - 在「开发定制 > 动态插件」列表上使用「Import dynamic plugin」动作上传(需要
DEVELOPER角色)。
「Import dynamic plugin」动作的参数窗口中有三项(界面上显示为英文):
| 参数 | 说明 |
|---|---|
| Plugin file | 要导入的插件 zip 包 |
| Ignore MD5 Check | 打开后不做文件更新判断,插件中的每个 CSV 文件都重新导入。只在插件包实际被导入时有效:系统中已有同名插件、新插件版本不更高、文件名不含 SNAPSHOT 且没有打开 Overwrite Conflict 时,整个插件包被忽略,打开这一项也不会导入任何 CSV(见下方导入规则) |
| Overwrite Conflict | 打开后,不论版本高低都用这个插件包覆盖系统中的同名插件,插件中的 CSV 导入时也跳过冲突检测,直接覆盖数据库中的值(见冲突检测与覆盖) |
导入规则:
- 多个插件按
PLUGIN_INFO中声明的依赖关系排序,被依赖的插件先导入;依赖的插件不存在、版本不满足或存在循环依赖时导入失败。 - 系统中已有同名插件时,只有新插件的版本更高、插件文件名中包含
SNAPSHOT,或者打开了 Overwrite Conflict 时才会覆盖;否则忽略这个插件包。 - 插件中的 CSV 同样按导入顺序导入,但
HierarchyRole、DynamicLogicEngine、DynamicLogicType、DynamicLogic、RoleRequirement、DomainClass、DomainClassField、ExtendedDomainClass会排在最前面。 - 文件名包含
SNAPSHOT的插件,效果与打开 Overwrite Conflict 相同:强制覆盖同名插件,导入 CSV 时强制覆盖冲突。
插件的开发和打包方式见 插件开发。
# 在列表页导入数据
平台内置了一个对象动作 Import domain data from csv(界面上显示为「导入数据」),可以把 CSV 文件导入到某个列表表单对应的模型中。这个动作默认没有绑定到任何表单,所以默认界面上看不到导入按钮,需要先把它绑定到目标列表表单:
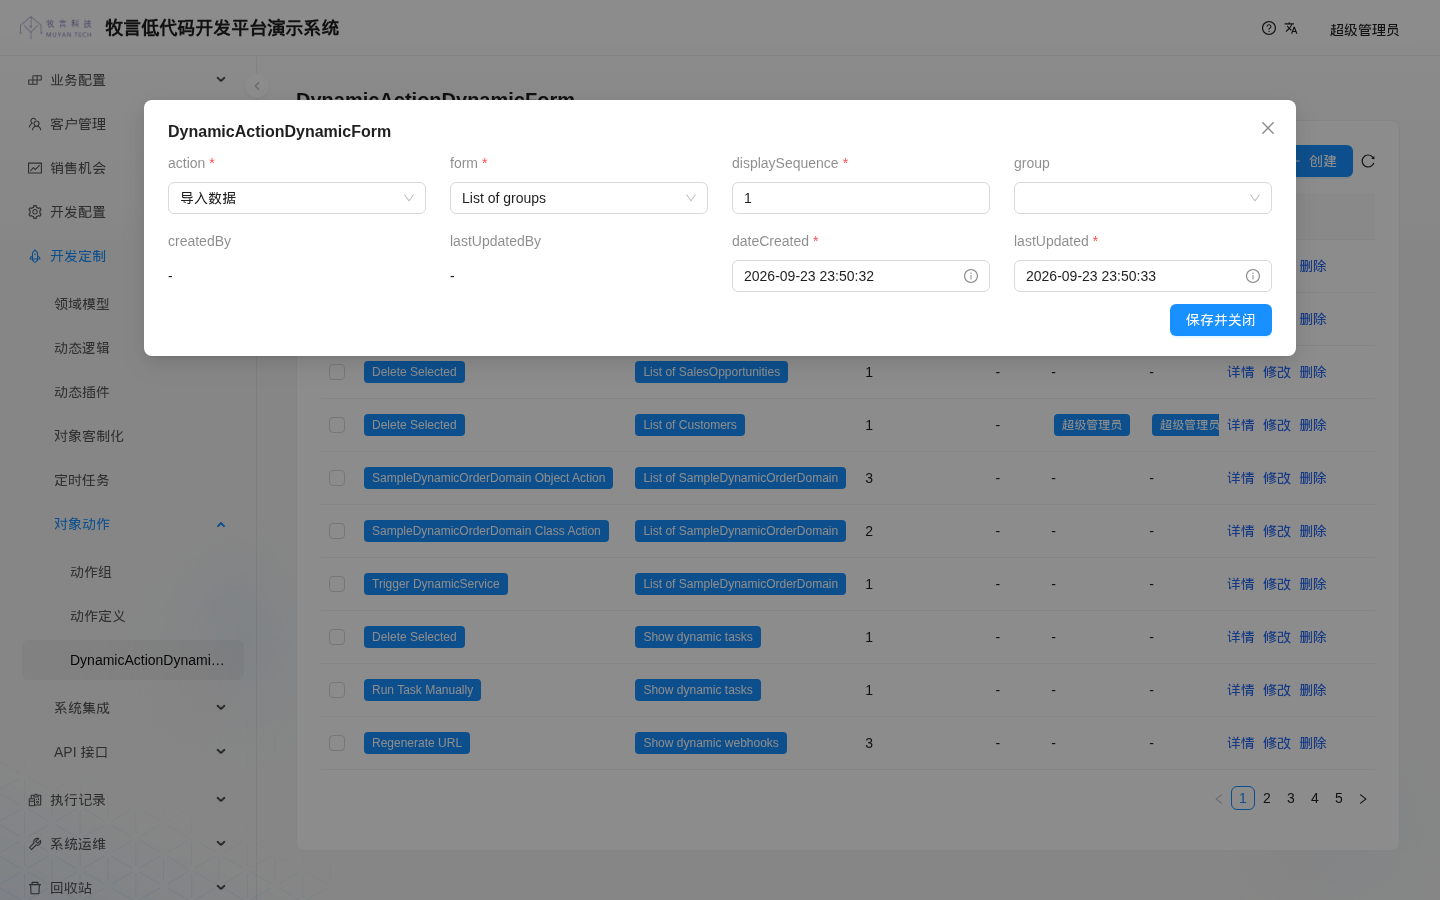
- 打开「开发定制 > 对象动作 > DynamicActionDynamicForm」,点击「创建」。
- action 选「导入数据」,form 选目标列表表单,填写 displaySequence 后保存。
下面以平台内置的用户组为例,把「导入数据」绑定到用户组的列表表单 List of groups:
注意
1.0.0-beta18 中,这个创建窗口的 dateCreated、lastUpdated 两个字段被标为必填,需要随便选一个时间(例如点「此刻」)才能保存,保存时系统会用实际时间覆盖。也可以用 CSV 绑定,见 CSV 导入模板 中的 DynamicActionDynamicForm 一节。
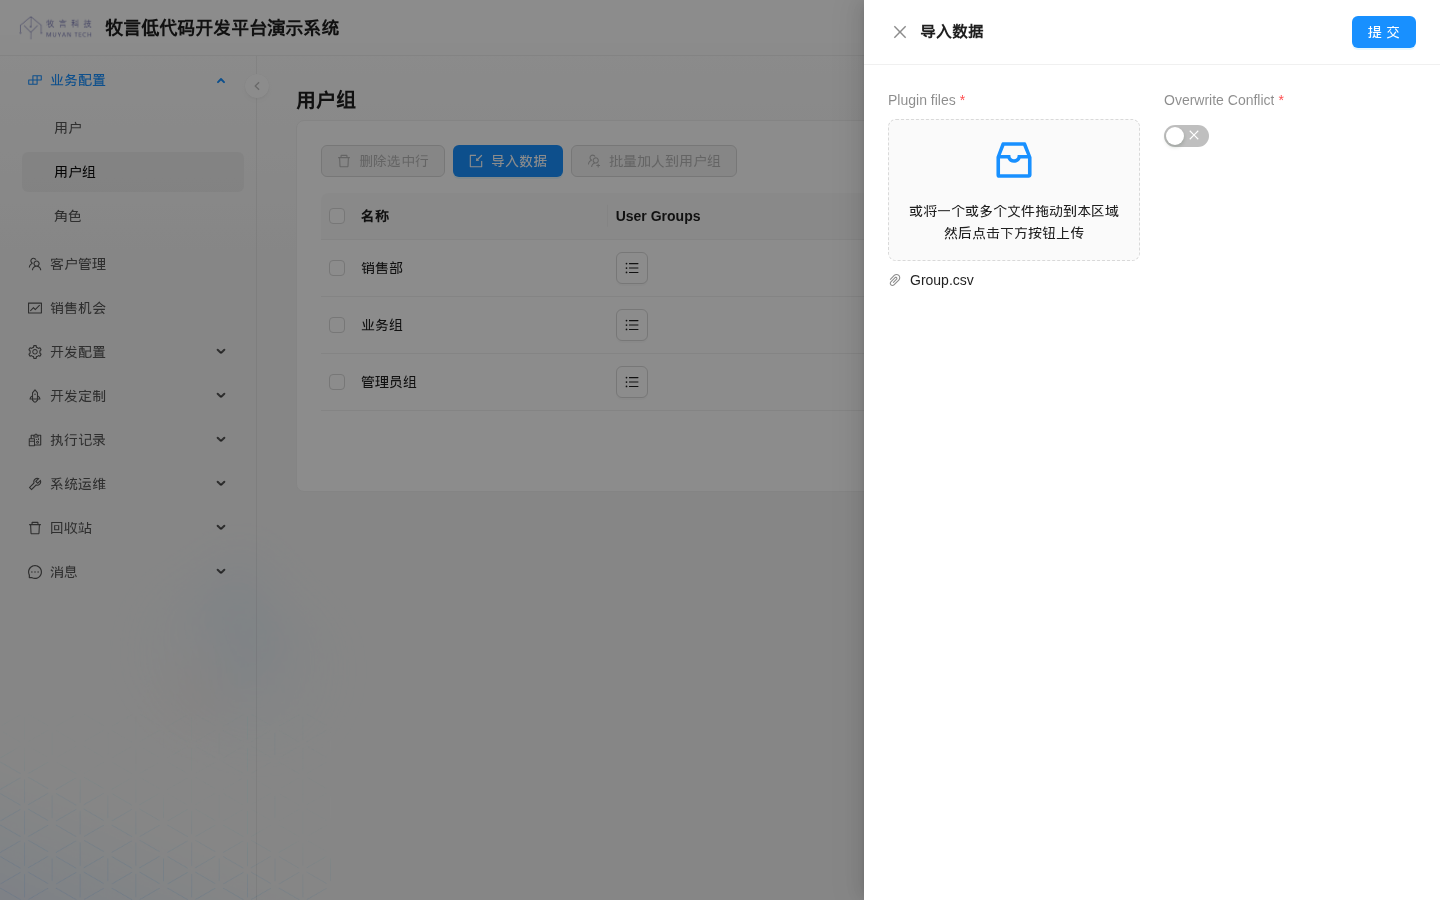
绑定后,「业务配置 > 用户组」列表上方出现「导入数据」按钮。准备一个 CSV 文件,例如 Group.csv:
name(*),roles.name[:]
市场部,[ROLE_USER]
客服部,[ROLE_USER]
2
3
点击「导入数据」,在上传框中选择一个或多个 CSV 文件,设置是否打开 Overwrite Conflict(覆盖冲突),点击「提交」。上传框的标题显示为「Plugin files」,这是当前版本的界面文案问题,这里选择的就是 CSV 文件:
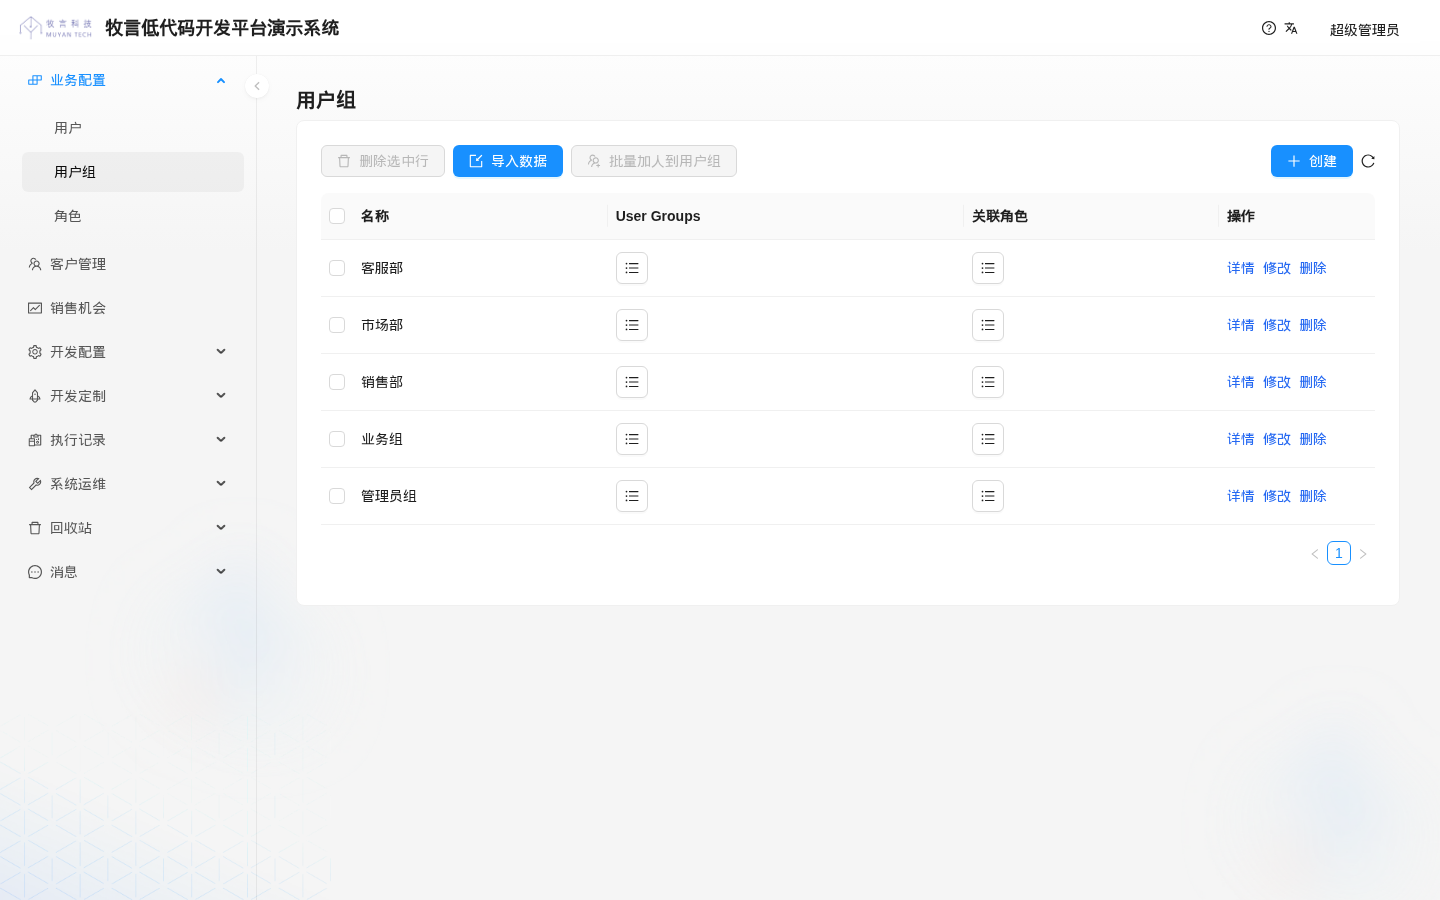
导入完成后刷新列表,可以看到新建的两个用户组(列标题「User Groups」未翻译是当前版本的界面问题):
- 导入的模型由列表表单的「关联对象类型」决定,与文件名无关。
- 动作异步执行,完成后系统发送消息通知,导入结果在「执行记录 > 数据导入」中查看。
- 这种方式不做文件更新判断,每次提交都会导入。
- 打开 Overwrite Conflict 时,冲突的行也会被 CSV 覆盖。
1.0.0-beta18 已知问题
- 向动态模型(在「开发定制 > 领域模型」中类型为 DYNAMIC 的模型,例如手把手教程中的客户、销售机会)导入数据时,当前每一行都会失败,失败原因为
ScopedValue not bound。系统启动时自动导入和「导入数据」动作都受影响;平台内置模型(如用户、用户组、表单、菜单)不受影响,上面的例子因此使用用户组。 - 即使所有行都导入失败,「导入数据」动作仍然提示「执行成功」,请以「执行记录 > 数据导入」中的状态为准。提交后的结果窗口里,「Execution record: <a href='/DynamicActionExecRecord/…'…」这段 HTML 原样显示为文本,没有渲染成链接;执行记录可以从随后收到的系统消息中的「执行日志」链接打开。
- 在界面上,只有
DEVELOPER及以上角色能使用「导入数据」:动作的参数表单Import domain data from csv RequestForm要求DEVELOPER角色,普通用户点击按钮后打不开参数表单(接口返回 403),导入结果所在的「执行记录 > 数据导入」也需要DEVELOPER。动作定义本身只要求USER角色,这只在直接调用动作接口时起作用;无论哪种方式,导入过程都不检查目标模型的新建、修改、删除权限。
# 种子数据目录
在 application.yml 中通过 seedData.folder 配置应用种子数据的根目录,默认读取环境变量 SEED_DATA_FOLDER,未设置时为 /app/data:
seedData:
  folder: ${SEED_DATA_FOLDER:/app/data}
2
以平台提供的 docker compose 开发工程为例,SEED_DATA_FOLDER 设置为 /app/plugin/data,工程中的 codes/data 下各子目录分别挂载到该目录下。
目录结构如下:
<seedData.folder>
├── Tenant.csv            --> 可选,系统首次启动时创建的租户列表
├── csv                   --> 种子数据 CSV 文件,文件名规则见「文件名称」
│   ├── DomainClass.csv
│   ├── DomainClassField.csv
│   └── ...
├── plugins               --> 可选,启动时自动导入的插件包
├── sql                   --> 可选
│   ├── before_import.sql --> 导入 CSV 之前执行
│   └── after_import.sql  --> 导入 CSV 之后执行
├── groovy                --> 一般放动态逻辑的源代码,由 CSV 中的 code(F) 列引用
├── css                   --> 一般放显示主题的 CSS,由 DynamicTheme 的 css(F) 列引用
└── attachments           --> 一般放需要导入的附件,如显示主题用到的 logo
2
3
4
5
6
7
8
9
10
11
12
13
groovy、css、attachments 只是约定俗成的目录名,CSV 中以文件路径引用它们,路径从种子数据根目录算起。
提示
目录下不再按运行环境、租户分子目录。Tenant.csv 只有一列 name(*),只在没有通过系统属性 gorm.tenantId(docker 镜像中由环境变量 TENANT_ID 设置)指定租户时使用,用于创建数据库中还不存在的租户。
# 导入顺序
一个目录中的 CSV 文件按以下顺序导入:
- 带前缀的文件,例如
000-DynamicLogicEngine.csv、006-DomainClass.csv,按文件名排序后最先导入。判断规则是:文件名中第一个_之前的部分恰好含一个-,-前面是前缀,后面是模型名。前缀一般用数字,便于排序。 - 预定义顺序的模型:
DisplayComponentModule、DynamicLogicEngine、DynamicLogicType、DynamicConfig、DynamicLogic、HierarchyRole、RoleRequirement、DynamicObjectHook、DomainClass、DomainClassField、DynamicFormType、DynamicForm、DynamicMenu、DynamicActionGroup、DynamicAction,按这个顺序导入。 - 其余文件:根据模型之间的关联关系自动排序,被依赖的模型先导入。例如同时存在
Group.csv、User.csv、UserGroup.csv时,UserGroup.csv在另外两个之后导入。
如果自动识别的依赖关系不满足需要,可以在模型定义中用 loadAfter 指定:
- 动态模型:在领域模型的扩展信息(
extInfo)中设置loadAfter,详见动态领域模型。 - 平台内置模型(GORM 模型):在类中定义静态属性
loadAfter,例如DynamicAction:
  // 表示在导入 DynamicAction 之前,需要先导入 DynamicLogic 和 DynamicActionGroup
  static loadAfter = [DynamicLogic, DynamicActionGroup]
2
如果某种对象不依赖其他对象、应尽早导入,可以把 loadAfter 设为空数组,例如 I18nType:
static loadAfter = []
# 文件更新判断
导入某个 CSV 文件前,系统计算文件内容的 md5,并查找这个模型的导入记录中 md5 相同、已经结束的最近一条记录。如果该记录的状态是「成功」或「无数据导入」,就跳过这个文件。
提示
- 判断依据是文件内容,与文件名、修改时间无关,加一行注释也会让文件重新导入。
- 系统只看 md5 相同的记录中最近结束的那一条:它是「成功」或「无数据导入」就跳过,是失败或部分失败就重新导入。所以把文件改回以前某个成功导入过的版本时,它不会被重新导入,这时可以加一行注释改变文件内容。
- 上次导入失败或部分失败的文件,下次启动时会整个文件重新导入。
# 导入前后执行 SQL
如果种子数据根目录(插件则是插件包根目录)下存在 sql/before_import.sql,系统在导入 CSV 之前执行它;存在 sql/after_import.sql 时,在导入 CSV 之后执行。
- SQL 中的
${TENANT}会被替换为当前租户标识。 - 每个租户都会执行一次。
- SQL 执行失败只记录错误日志,不会中断导入。
# CSV 文件格式
以下章节描述了 CSV 文件数据准备相关的内容。
# 文件名称
文件名决定导入的模型:取文件名中第一个 _ 之前的部分,再去掉 - 及其之前的数字前缀,得到模型的简略名称(不含包名)。例如以下文件都导入到 DynamicForm:
DynamicForm.csvDynamicForm_crm.csv011-DynamicForm_action.csv
.csv 后缀需要小写。动态模型使用领域模型的简略名称,例如 Customers_2026.csv。
# 标题行
所有待导入的 CSV 文件中,第一行均应该是标题行,标题行描述了该 CSV 文件中数据的结构。以下是一个标题行的示例:
username(*),password,name,accountLocked,DELETE_FLAG
- 普通列的名称是模型中的字段名。
- 后缀
(*)的列,如username(*),是查询字段,见查询字段。 - 包含
.的列,如group.name,是关联对象字段,见关联对象的查询。 - 后缀
(F)的列,如code(F),表示该列的值是一个文件路径,导入时读取文件内容作为字段值。路径从种子数据根目录(插件则是插件包根目录)算起。 - 名为
DELETE_FLAG的列用于删除数据,见对象删除。 - 名为
OVERWRITE_FLAG的列用于强制覆盖,见冲突检测与覆盖。 - 如果某字段的类型是附件(
StorageFieldValue),该列的值为待导入附件的文件路径。
注意
标题行中出现模型里不存在的列名时,整个文件导入失败;系统启动时自动导入的情况下,同一目录中排在它后面的文件以及 after_import.sql 也不会再执行。1.0 以前的动态字段列(以 (#) 结尾)1.0 起已移除,出现时同样会导致整个文件失败。
# 注释行
以英文分号(;)开头的行是注释行,导入时会被忽略:
name(*),implies.name[:]
;; 销售角色,包含普通用户角色
ROLE_SALES,[ROLE_USER]
2
3
# 查询字段
为了支持通过 CSV 文件创建或更新现有记录,所有在标题行中后缀是 (*) 的列会被识别为查询字段。系统用所有查询字段的值,按严格相等查询现有记录:
- 查询结果为空:新建一条数据,导入记录中该行记为新建。
- 查询结果只有一条:用 CSV 中的值更新这条数据,导入记录中该行记为更新;如果值没有变化,记为无更新。
- 查询结果超过一条:跳过该行,导入记录中该行记为跳过。
提示
如果导入的 CSV 文件中没有任何查询字段,则更新和删除都不可用,所有记录都按新建处理。
# 关联对象的查询
如 group.name,表示导入该对象的 group 字段(一个 Group 对象)时,用 CSV 中该列的值去匹配 Group 的 name 字段,把查到的对象关联起来:
- 查不到关联对象:该行导入失败。
- 查到一个:继续该行的导入。
- 查到多个:该行导入失败。
关联字段也可以作为查询字段,如 user.username(*)。
对于一对多、多对多的集合字段,值写成 [值1,值2],列名写成 roles.name[] 或 roles.name([] 可以省略,默认用逗号分隔;值中含逗号,整格要用双引号包起来)。也可以在方括号中指定分隔符,例如 roles.name[:] 表示用 : 分隔,值写成 [ROLE_A:ROLE_B],这样就不需要引号。
如果列名只写了字段名、没有写查询字段:
- 单个关联对象(例如
customer):系统使用关联模型扩展信息中的queryField作为查询字段;关联模型也没有配置queryField时,该列的值无法解析,对应的行导入失败。 - 集合字段(例如
roles):默认按关联对象的name字段查找。
注意
导入某对象时,它所依赖的关联对象必须已经在系统中存在,否则该行导入会失败。
# 空值
单元格为空,或填写字面量 NULL,该字段都按空值(null)导入。
# 特殊字符的转义
- 如果某列的内容中包含英文逗号(
,)或换行,该列需要用英文双引号(")包裹起来。 - 被双引号包裹的内容中,英文双引号写两遍(
"")表示一个双引号,也可以用反斜杠转义(\")。例如 JSON 值{"labelField": "name"}在 CSV 中写作"{""labelField"": ""name""}"。 - 反斜杠(
\)是转义符:\\表示一个反斜杠,\n、\t会被转换成换行和制表符,反斜杠后面跟其他字符时原样保留(例如C:\data不变)。值中需要保留\n这样的字面内容时,把反斜杠写成\\。
# 空白字符处理
在从 CSV 文件中读取数据时,系统会自动去掉每列前后的空白字符。
# 对象删除
CSV 文件导入时,支持删除现有数据,方法是:
- 在 CSV 文件的标题行中增加
DELETE_FLAG列; - 对于要删除的行,将其
DELETE_FLAG列的值设置为Y(取值规则同布尔值)。
注意
CSV 文件的标题行中必须有能唯一确定一条记录的查询字段,删除才能正确工作。
被标记为删除的行:
- 查到 0 条现有数据:记录一条警告,不做任何操作。
- 查到多条现有数据:跳过这一行。
- 文件中没有查询字段:所有标记为删除的行都不会删除任何数据。
# 冲突检测与覆盖
每一行导入成功(新建或更新)后,系统会把该行的原始内容记录到「执行记录 > 行导入成功记录」中。之后再次导入同一条数据时,系统比较三份内容:数据库中的当前值、上次导入的 CSV 行、本次的 CSV 行。
以覆盖冲突方式导入时(「导入数据」或「Import dynamic plugin」动作中打开了 Overwrite Conflict,或插件文件名包含 SNAPSHOT),导入成功的行不会写入行导入成功记录。下一次以普通方式导入时,系统比较的仍是更早那次导入留下的记录。
| 界面上改过 | CSV 改过 | 结果 |
|---|---|---|
| 否 | 是 | 正常更新 |
| 是 | 否 | 跳过,保留界面上的修改(导入记录中计入「数据库更新但 CSV 未更新」) |
| 是 | 是 | 判定为冲突,不更新,该行记入冲突行 |
以下情况会跳过冲突检测,直接用 CSV 覆盖数据库中的值:
- 该行的
OVERWRITE_FLAG列值为Y; - 「导入数据」动作中打开了 Overwrite Conflict;
- 插件包的文件名中包含
SNAPSHOT。
提示
从来没有通过 CSV 导入过的数据(例如在界面上新建的表单),第一次用 CSV 更新时没有上次导入的记录,不会判定为冲突。
# 数据类型映射
如下列出了平台内置模型的字段类型与 CSV 中值的转换关系:
| 字段类型 | CSV 中的值 |
|---|---|
String | 原样导入 |
Boolean | 见布尔值 |
Integer、Long、Double、BigDecimal | 数字 |
java.time.LocalDate、LocalDateTime、ZonedDateTime、OffsetDateTime、java.util.Date | 见日期及时间 |
| 枚举 | 见枚举类型 |
org.springframework.http.HttpMethod | GET、POST 等 |
tech.muyan.storage.StorageFieldValue | 附件的文件路径 |
| 关联对象 | 见关联对象的查询 |
Set、List 集合 | [值1,值2],见关联对象的查询 |
动态模型的字段按领域模型字段的数据类型(dataType)转换,规则相同。
平台不提供注册自定义类型转换的扩展点。
# Boolean
对于 Boolean 类型的字段,值的对应关系如下,不在范围内的值会导致该行导入失败:
| CSV 文件中的值 | 导入后的值 |
|---|---|
Y, y, Yes, YES, true, TRUE, T, t, 是, 1 | true |
N, n, No, NO, false, FALSE, F, f, 否, 0 | false |
# 日期及时间
支持以下格式,格式中各字母的含义可参考 SimpleDateFormat (opens new window):
 "yyyyMMdd"
 "dd-MM-yyyy"
 "yyyy-MM-dd"
 "MM/dd/yyyy"
 "yyyy/MM/dd"
 "dd MMM yyyy"
 "dd MMMM yyyy"
 "yyyyMMddHHmm"
 "yyyyMMdd HHmm"
 "dd-MM-yyyy HH:mm"
 "yyyy-MM-dd HH:mm"
 "MM/dd/yyyy HH:mm"
 "yyyy/MM/dd HH:mm"
 "dd MMM yyyy HH:mm"
 "dd MMMM yyyy HH:mm"
 "yyyyMMddHHmmss"
 "yyyyMMdd HHmmss"
 "dd-MM-yyyy HH:mm:ss"
 "yyyy-MM-dd HH:mm:ss"
 "MM/dd/yyyy HH:mm:ss"
 "yyyy/MM/dd HH:mm:ss"
 "dd MMM yyyy HH:mm:ss"
 "dd MMMM yyyy HH:mm:ss"
 "yyyy-MM-dd'T'HH:mm:ss.SSS'Z'"
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
# 枚举类型
枚举字段只接受枚举常量名,并且大小写必须完全一致,例如 DynamicMenu 的 type 列写 FORM,而不是界面上显示的 Form。其他值会导致该行导入失败。
# 附件类型
对于附件类型的列,填写从种子数据根目录起算的相对文件路径,导入时系统会把该文件保存为附件(StorageFieldValue),并与导入的对象关联。
# 查看导入记录
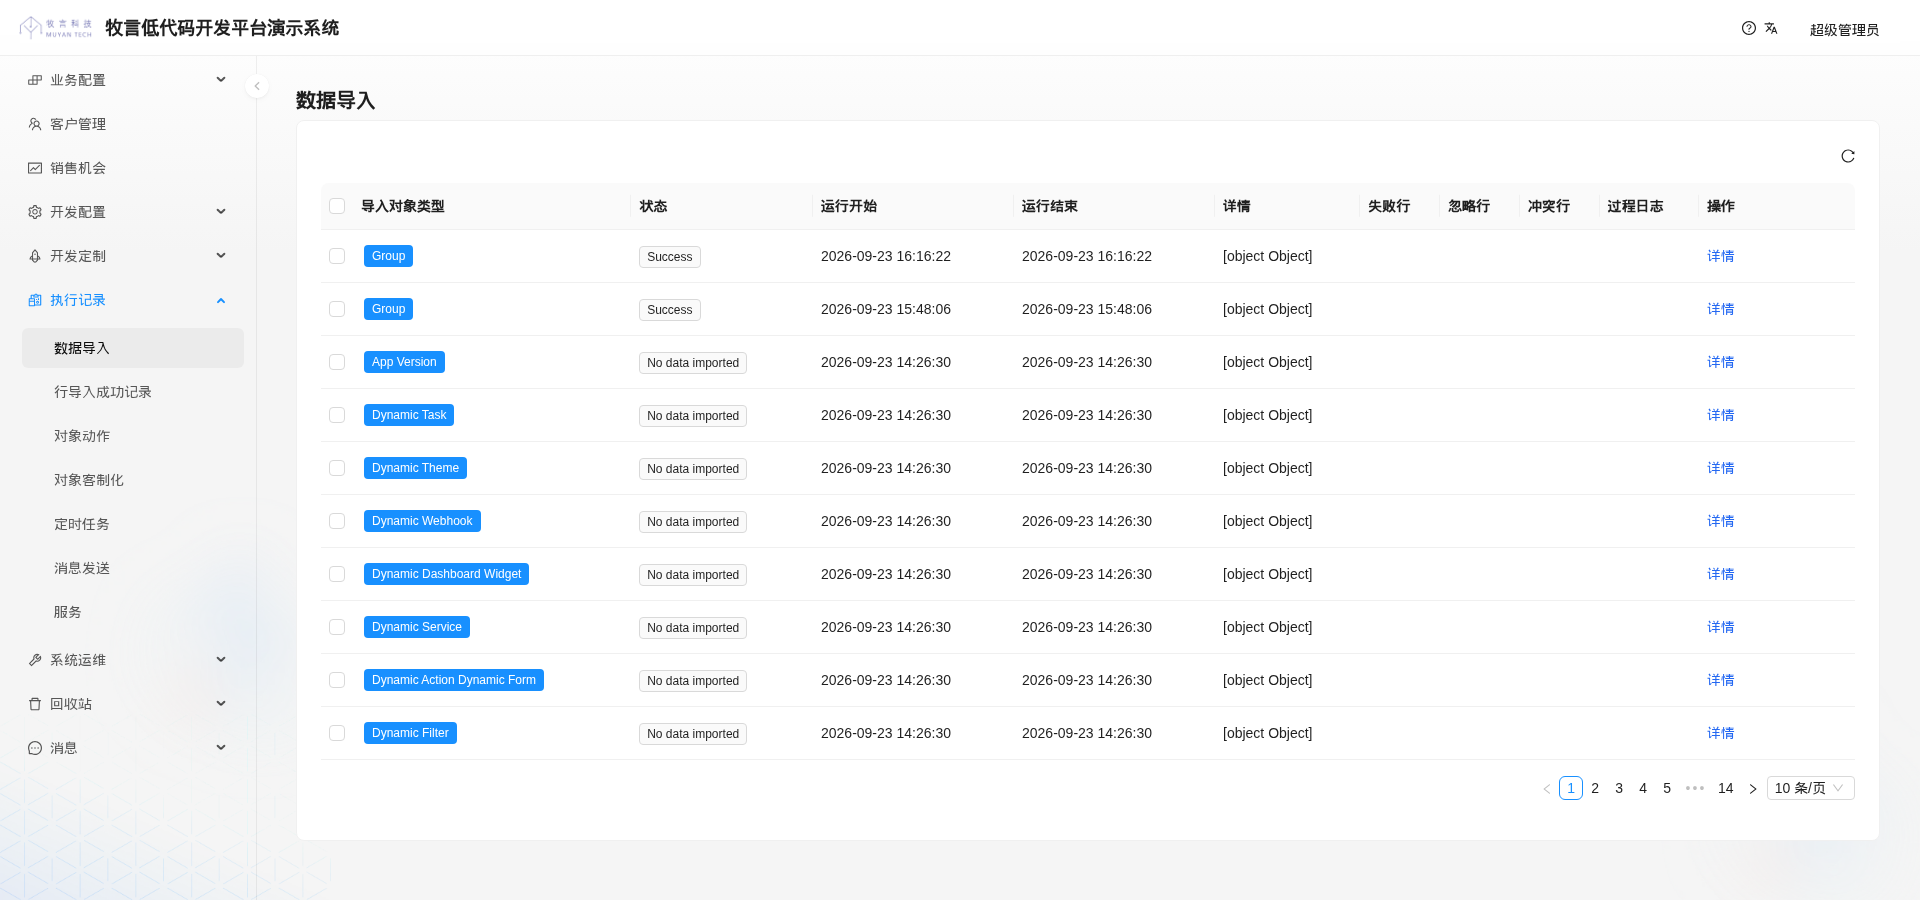
每个 CSV 文件的导入过程都会记录在「执行记录 > 数据导入」中,查看需要 DEVELOPER 角色。下图第一行是上面导入用户组的记录:
导入记录中保存了以下信息:
- 导入对象的类型、导入 CSV 文件的 md5、标题行
- 导入状态,取值:
- 成功(
SUCCESS) - 部分失败(
PARTIALLY_FAIL) - 失败(
FAILED) - 运行中(
RUNNING) - 无数据导入(
NO_DATA_IMPORTED) - 未开始(
NOT_START) - 部分成功(
PARTIALLY_SUCCESS,已废弃)
- 成功(
- 导入开始、结束时间
- 新建、更新、删除、无更新、冲突、失败、「数据库更新但 CSV 未更新」的对象 id 及数量
- 失败行、跳过行、冲突行、「数据库更新但 CSV 未更新」的行在 CSV 中的原始内容
- 导入过程的日志
注意
1.0.0-beta18 中,数据导入列表的「详情」列显示为 [object Object],点击行上的「详情」会导致页面报错;状态显示为英文(Success、Failed 等)。失败原因可以在列表的「失败行」「过程日志」列中查看。
另外,数据导入列表的「运行开始」「运行结束」按 UTC 原样显示,没有换算成浏览器所在时区;下面「行导入成功记录」中的「导入时间」则已换算成本地时间。在东八区查看时,同一次导入在两个列表中的时间相差 8 小时(上图第一行的 16:16 与下图前两行的 00:16 是同一次导入)。
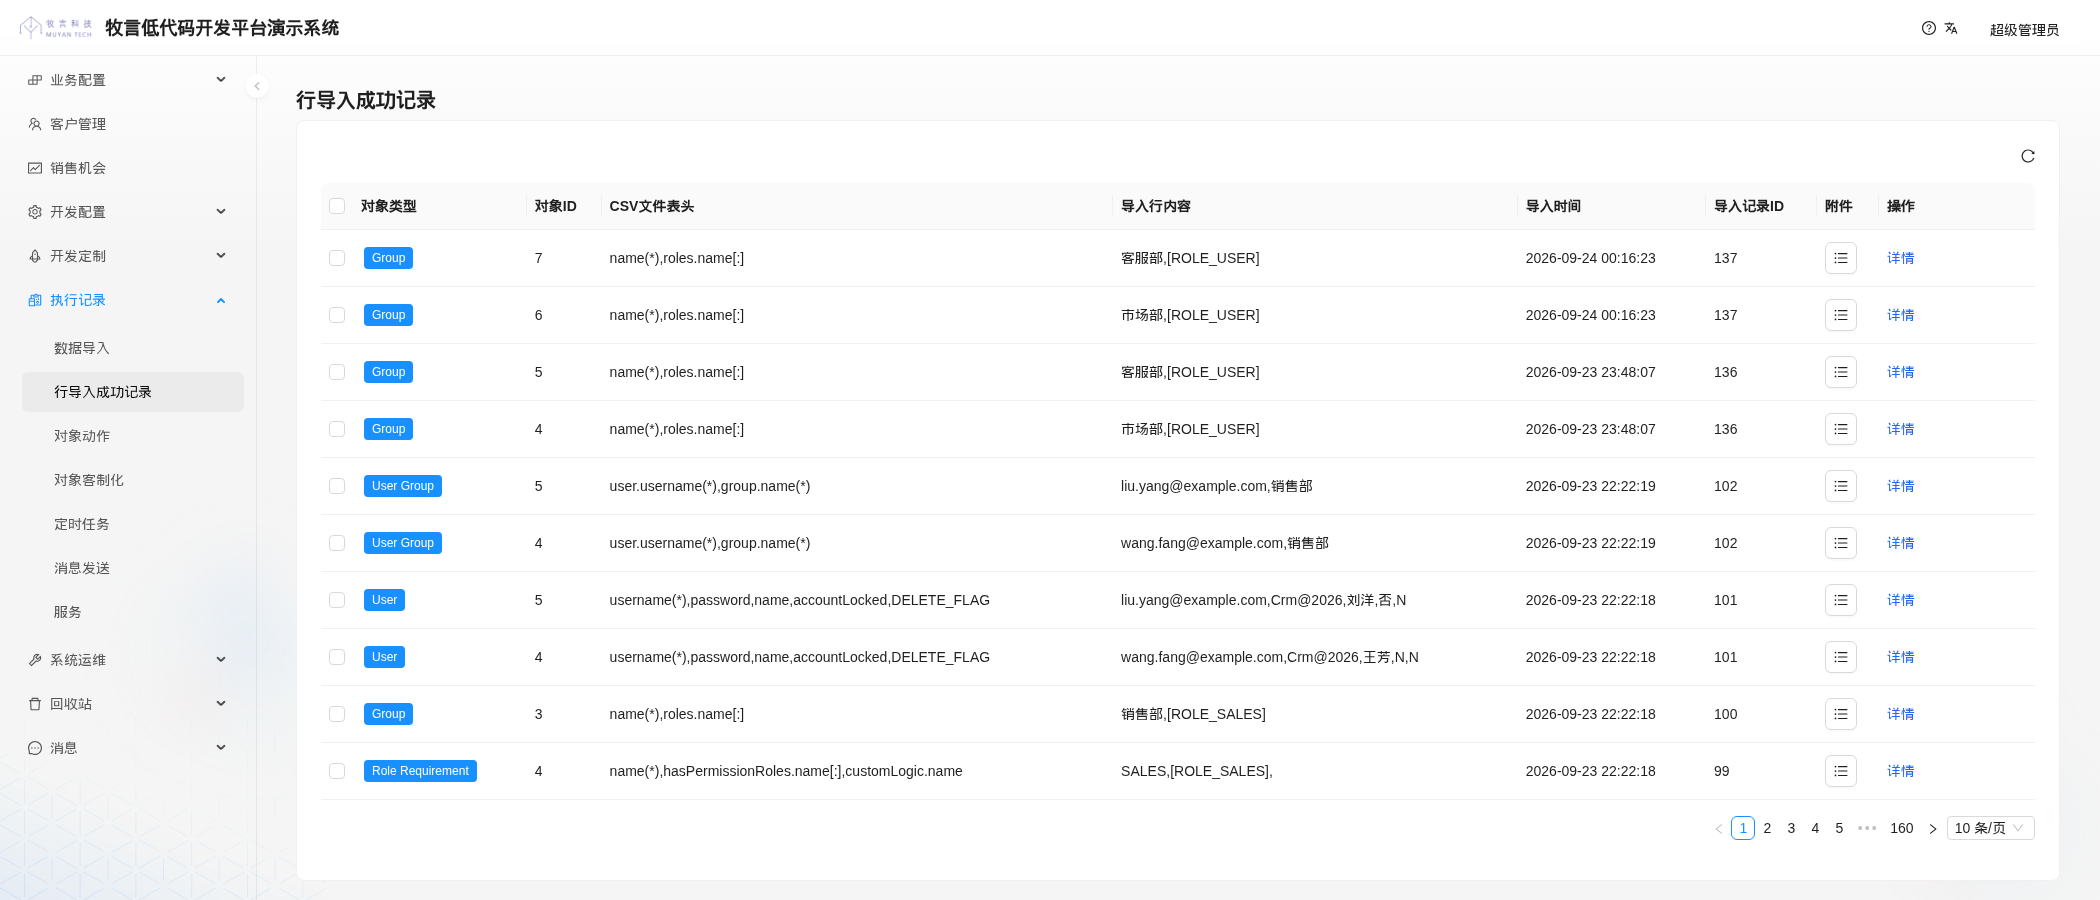
每一行导入成功的记录保存在「执行记录 > 行导入成功记录」中,冲突检测依赖这些记录:
# 一个完整的例子
下面的例子新建一个销售角色、一个销售部用户组和两个销售人员,并把人员加入用户组。在 csv 目录下新建以下文件(文件名后缀 _crm 可以任取):
HierarchyRole_crm.csv:
name(*),implies.name[:]
;; 销售角色,包含普通用户角色
ROLE_SALES,[ROLE_USER]
2
3
RoleRequirement_crm.csv:
name(*),hasPermissionRoles.name[:],customLogic.name
SALES,[ROLE_SALES],
2
Group_crm.csv:
name(*),roles.name[:]
销售部,[ROLE_SALES]
2
User_crm.csv:
username(*),password,name,accountLocked,DELETE_FLAG
[email protected],Crm@2026,王芳,N,N
[email protected],Crm@2026,刘洋,否,N
2
3
UserGroup_crm.csv:
user.username(*),group.name(*)
[email protected],销售部
[email protected],销售部
2
3
重启后端服务后,导入顺序为:HierarchyRole_crm.csv、RoleRequirement_crm.csv(预定义顺序),然后是 Group_crm.csv、User_crm.csv、UserGroup_crm.csv(按依赖关系排序,UserGroup 依赖 User 和 Group,排在最后)。
# 文件说明
- 文件名到模型的映射:
User_crm.csv中第一个_之前是User,所以导入到User模型;后缀_crm只用于区分文件。 - 现有记录查找:
User_crm.csv中只有username(*)是查询字段,按用户名查找现有用户,找到就更新,找不到就新建;UserGroup_crm.csv中user.username(*)和group.name(*)两个关联字段同时作为查询字段。 - 关联对象查询:
group.name(*)表示用Group的name字段匹配用户组。
# 字段说明
implies.name[:]、roles.name[:]、hasPermissionRoles.name[:]- 集合字段,值写在方括号中,多个值用
:分隔。例如[ROLE_SALES]表示关联名为ROLE_SALES的角色。 - 关联的对象必须已经存在:
ROLE_SALES在HierarchyRole_crm.csv中创建,它按预定义顺序先于Group_crm.csv导入。
- 集合字段,值写在方括号中,多个值用
accountLocked- Boolean 字段,
N和否都会被转换为false,见布尔值。
- Boolean 字段,
password- 用户的初始密码,导入时系统会加密保存到用户表(注意:CSV 行原文,包括明文初始密码,会保存在「执行记录 > 行导入成功记录」中,DEVELOPER 及以上角色可以看到;请只用临时初始密码,并要求用户首次登录后修改)。
DELETE_FLAG- 值为
N,表示执行新建或更新。要删除某个用户时,把该行的值改为Y后重新导入。
- 值为
customLogic.name- 留空,表示该角色要求不使用自定义逻辑,只按角色判断。